Apéndice F: Espacialización Sonora y Audio Inmersivo 3D (`IRCAM Spat5` y `Ambisonics`)
El sonido en el mundo físico no es un fenómeno estéreo ni una línea que sale de dos monitores de estudio: es un campo de presión acústica tridimensional continuo que interactúa con la geometría del espacio, los materiales y la fisionomía de nuestra cabeza y pabellón auditivo.
En la música electroacústica, los conciertos multicanal, el diseño sonoro de videojuegos y la realidad virtual, Max/MSP es el estándar de facto a nivel mundial para el procesamiento y espacialización de audio 3D. En este apéndice abordamos los dos paradigmas matemáticos y acústicos fundamentales: IRCAM Spat5 y Ambisonics de Orden Superior (HOA).
1. Los Paradigmas de Espacialización 3D
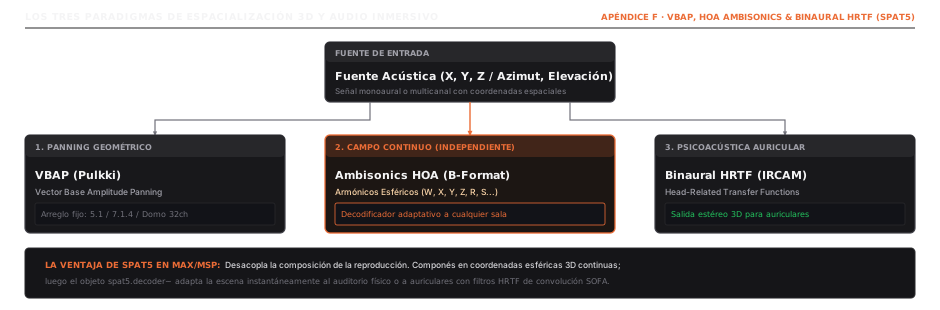
1.1. VBAP (Vector Base Amplitude Panning - Ville Pulkki)
- Divide el espacio tridimensional de parlantes en triángulos (o pares en 2D).
- Calcula la ganancia de cada altavoz como una combinación lineal de vectores de base en coordenadas cartesianas. Si la fuente virtual coincide con un parlante, solo ese parlante suena; si se mueve entre ellos, la energía se reparte preservando la potencia acústica total.
1.2. Ambisonics de Orden Superior (HOA - Gerzon / Daniel / Di Liscia)
- Desacoplamiento Total: En lugar de mezclar para un número fijo de parlantes, se codifica la direccionalidad de la onda en una serie de armónicos esféricos independientes de la disposición física de los altavoces.
Ecuaciones Canónicas de Codificación FuMa (Oscar Pablo Di Liscia / Mariano Cura)
En el tratado Síntesis Espacial de Sonido (UNQ / CMMAS), Oscar Pablo Di Liscia y Mariano Martín Cura detallan la síntesis de señales formato B a partir de coordenadas espaciales normalizadas en una esfera unitaria: azimut (plano horizontal), elevación (plano vertical) y distancia :
-
Primer Orden (4 Canales: ):
donde es el componente omnidireccional de presión de referencia y son los componentes dipolares ortogonales correspondientes a los ejes adelante/atrás, izquierda/derecha y arriba/abajo.
-
Segundo Orden (9 Canales: suma de ): Añade armónicos esféricos cuadrupolares para mayor selectividad direccional y resolución angular en recintos amplios:
Decodificación de Fase Corregida / Control de Opuestos (Gordon Monro / Malham)
La decodificación directa general recrea un frente de onda ideal en un punto central infinitesimal (sweet spot), pero genera altavoces que emiten señales en contrafase respecto a los opuestos. Como documenta Di Liscia, en una sala de conciertos esto degrada severamente la localización para los oyentes periféricos. Para resolverlo, se aplican ponderaciones en fase (in-phase decoding) donde la ganancia de cada altavoz ubicado en garantiza que todos los parlantes colaboren constructivamente sin cancelaciones destructivas:
1.3. Las Herramientas ICST Ambisonics de Zurich (Schacher & Kocher, ICMC 2006)
Desarrollado en el Institute for Computer Music and Sound Technology (Zurich), el paquete ICST Ambisonics es una de las implementaciones canónicas de código abierto más potentes para Max/MSP:
- Higher Order Ambisonics (HOA) Escalable: Soporta codificación y decodificación 3D desde primer orden (4 canales) hasta 7mo orden (64 canales de armónicos esféricos).
- Manipulación Espacial en el Dominio B-Format: En lugar de recalcular las posiciones de los altavoces ante cada movimiento de escena, los objetos de ICST permiten rotar, inclinar y ladear (Yaw, Pitch, Roll) el campo sonoro tridimensional completo operando directamente sobre la matriz ortogonal de señales B-Format mediante multiplicaciones de armónicos esféricos.
- Modos de Decodificación Optimizada:
- Basic / Strict: Reconstrucción ideal del frente de onda en el centro geométrico.
- Max : Optimiza el vector de energía para maximizar la nitidez direccional percibida en recintos medianos.
- In-Phase: Anula totalmente los lóbulos de energía negativa en los altavoces traseros/opuestos, expandiendo el área de escucha útil (sweet spot) para toda la audiencia en auditorios.
1.4. ViMiC: Virtual Microphone Control (Peters, Matthews, Braasch & McAdams, CIRMMT / McGill, 2008)
Frente a los métodos vectoriales (VBAP) o de campo difuso (Ambisonics), el paradigma ViMiC (Virtual Microphone Control) propone una aproximación psicoacústica basada en técnicas de microfonía física de estudio:
- Configuración de Cápsulas Virtuales: El usuario define en el espacio 3D de Max un arreglo de micrófonos virtuales (pares espaciados AB, pares coincidentes XY estéreo, configuraciones binaurales o arreglos multicanal 5.1 / 7.1).
- Directividad Paramétrica Continuamente Variable: Cada cápsula virtual emula diagramas polares analógicos reales según la ecuación: donde es omnidireccional, cardioide, y figura en 8 (bidireccional).
- Reflexiones Tempranas por el Método de Fuentes Imagen (Image-Source Method): Cada pared, suelo y techo de la sala acústica virtual actúa como un reflector especular. Max calcula la posición de fuentes virtuales espejadas, inyectando los retardos temporales y las atenuaciones de pared correspondientes a los coeficientes de absorción de los materiales, proveyendo una sensación de envolvente y tamaño de sala hiperrealista sin sobrecargar la CPU.
2. Espacialización Multicanal Nativa: De la Cuadrafonía al Paneo Cúbico 3D (Christopher Dobrian)
Mientras que las librerías avanzadas como Spat5 dependen de arquitecturas externas complejas, Christopher Dobrian (University of California, Irvine) demostró en sus tratados para PdMaxCon y Computer Music Programming (CMP) que la espacialización multicanal de calidad profesional puede implementarse íntegramente con objetos nativos estándar de Max/MSP.
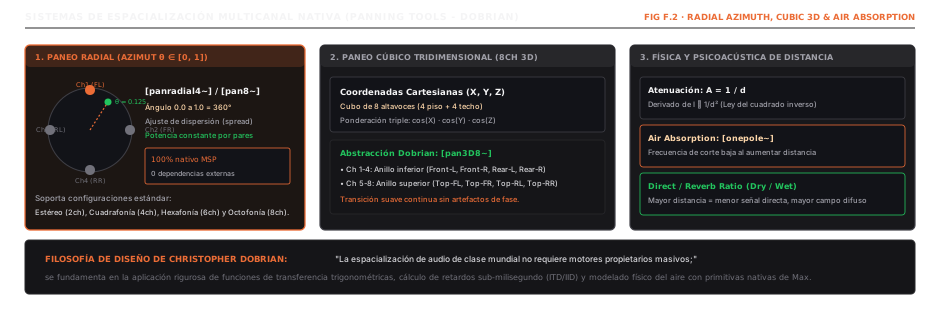
2.1. Paneo Radial por Ángulo de Acimut ()
En lugar de depender de coordenadas cartesianas independientes para cada eje, Dobrian formaliza el paneo radial dividiendo el círculo de altavoces en una escala normalizada de a (donde y corresponden al frente-centro, a las 12 en punto):
- Cuadrafonía (4 canales): Altavoces ubicados en (Front-Left), (Front-Right), (Rear-Left) y (Rear-Right).
- Hexafonía (6 canales): Separados a intervalos angulares exactos de ().
- Octofonía (8 canales): Separados a ().
Dobrian introduce el parámetro de Dispersión (Spread): al reducir el spread, el sonido se confina estrictamente al par de altavoces adyacentes; al aumentarlo hacia , la energía se desparrama gradualmente por todos los altavoces del recinto, creando campos difusos inmersivos con preservación de la potencia constante por pares.
2.2. Paneo Cúbico Tridimensional en 8 Altavoces (pan3D8~)
Para salas con altavoces en altura (4 en el suelo y 4 en el techo formando un cubo acústico), Dobrian calcula la matriz tridimensional mediante la multiplicación combinada de tres proyecciones ortogonales de potencia constante: Esto permite que una fuente sonora navegue libremente por el interior del cubo virtual en coordenadas cartesianas o esféricas sin saltos de fase ni discontinuidades espectrales.
2.3. Psicoacústica de la Distancia y Localización (Dobrian CMP)
El paneo de amplitud por sí solo no transmite la sensación de lejanía. El cerebro humano localiza fuentes en el espacio evaluando cuatro fenómenos físicos simultáneos:
- Ley del Cuadrado Inverso e Intensidad (): La intensidad acústica decrece con el cuadrado de la distancia (). Como la intensidad es proporcional al cuadrado de la amplitud (), la amplitud debe atenuarse de forma estrictamente inversamente proporcional a la distancia:
- Absorción Atmosférica de Altas Frecuencias (Air Absorption):
El aire disipa la energía térmica de las ondas sonoras, afectando con mucha mayor severidad a las longitudes de onda cortas (agudas). Dobrian implementa este fenómeno insertando un filtro pasa-bajos de un polo (
[onepole~]) cuya frecuencia de corte desciende logarítmicamente conforme la fuente se distancia del oyente. - Relación Directo / Reverberado (Direct-to-Reverberant Ratio): Una fuente cercana emite sonido predominantemente directo. Al alejarse, la energía directa cae rápidamente, mientras que el campo reverberado difuso de la sala se mantiene casi constante. Modulando la proporción Dry/Wet en función de , el cerebro deduce instantáneamente la profundidad espacial de la escena sonora.
- Diferencias Interaurales de Tiempo e Intensidad (ITD / IID & Efecto Haas): Las diferencias temporales de llegada entre ambos oídos (menores a ) dominan la percepción de acimut en frecuencias graves (< ), mientras que la sombra acústica de la cabeza (IID) domina en frecuencias agudas.
3. La Suite IRCAM Spat5: Acústica y Percepción
El paquete Spat5 (desarrollado por el equipo de Representaciones Musicales del IRCAM) no solo posiciona el sonido en el espacio, sino que modela la acústica perceptiva de recintos:
- Sonido Directo (Direct Sound): Retardo temporal por distancia () y atenuación por ley del cuadrado inverso de la distancia ().
- Reflexiones Tempranas (Early Reflections): Ecos discretos generados por las paredes que informan al cerebro sobre el tamaño aparente de la habitación.
- Reverberación Tardía (Late Reverberation): Redes de retardo con retroalimentación (FDN - Feedback Delay Networks) densas, homogéneas y libres de coloración tímbrica.
- Control Perceptivo: En lugar de ajustar coeficientes biquad abstractos, Spat5 te permite automatizar atributos psicoacústicos: Source Presence (presencia de la fuente), Warmth (calidez acústica), Envelopment (envolvimiento del oyente) y Room Size (volumen del espacio).
4. Laboratorio Práctico: Panner Circular 3D con Simulación de Distancia y Headroom
En el parche interactivo lab_apendice_f_audio_espacial.maxpat:
- Implementamos una fuente sonora en órbita tridimensional circular continua.
- Calculamos el retardo temporal variable de propagación del aire con
delay~. - Modulamos la atenuación de alta frecuencia dependiente de la distancia del aire mediante un filtro pasa-bajos dinámico.
- Distribuimos la energía sonora a un sistema de 4 cuadrantes (cuadrafónico simulado) con atenuación de headroom nominal de -12 dB.