Apéndice E: Inteligencia Artificial y Machine Learning en Max (`FluCoMa` y `nn~`)
La integración del Machine Learning (ML) y el Deep Learning (DL) en Max/MSP transformó radicalmente la música interactiva, la síntesis sonora y el diseño de instrumentos digitales. Ya no estamos limitados a reglas heurísticas lineales escritas a mano (if/else o mapeos rígidos con scale); ahora podemos entrenar redes neuronales que aprenden relaciones complejas entre gestos humanos y síntesis sonora, segmentar corpus de audio gigantescos y ejecutar modelos generativos en tiempo real.
En este apéndice analizamos los dos frameworks más revolucionarios del campo: FluCoMa y nn~ (IRCAM).
1. FluCoMa (Fluid Corpus Manipulation): Machine Learning Creativo
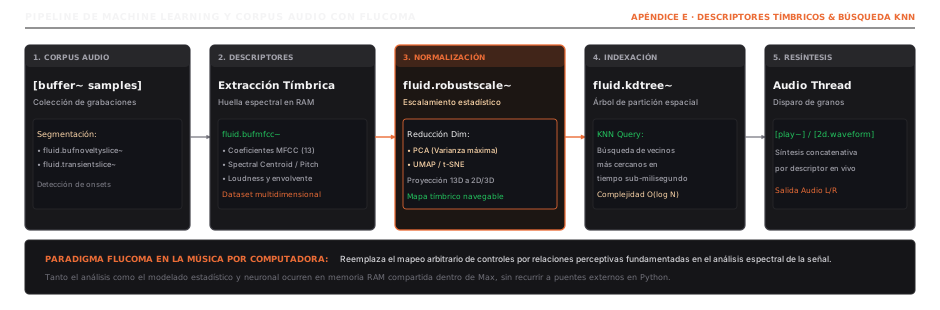
Desarrollado por la Universidad de Huddersfield, FluCoMa provee un conjunto masivo de objetos en C++ para análisis de señal, descomposición espectral y algoritmos de Machine Learning estadístico y neuronal:
1.1. Los Tres Pilares de FluCoMa
- Descomposición Espectral:
fluid.transientslice~: Separación de transitorios percusivos del cuerpo armónico continuo mediante análisis de energía residual.fluid.sines~: Extracción sinusoidal aditiva.fluid.nmf~: Factorización de Matrices No Negativas para desmezclar instrumentos superpuestos en un mismo archivo de audio.
- Espacios Tímbricos y Descriptores:
fluid.mfcc~: Coeficientes Cepstrales en las Frecuencias de Mel (la “huella dactilar” del timbre acústico).fluid.spectralshape~: Centroide espectral, dispersión, asimetría y brillo.
- Modelos Estadísticos y Redes Neuronales:
fluid.kdtree~: Indexación espacial multidimensional para búsquedas ultra-rápidas en sub-milisegundos.fluid.mlpclassifier~yfluid.mlpregressor~: Redes Neuronales Multicapa (Perceptrón Multicapa - MLP) entrenables directamente en Max sin depender de Python.
2. Deep Learning en el Audio Thread: nn~ de IRCAM y Modelos RAVE
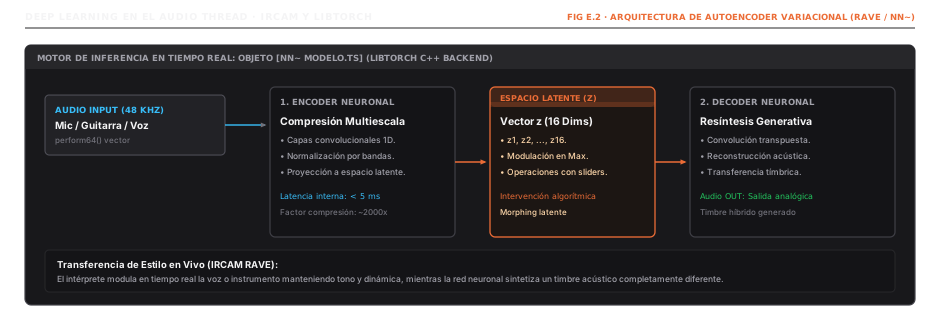
Mientras que FluCoMa opera con descriptores y redes densas, nn~ (creado por Antoine Caillon y Philippe Esling en el IRCAM) resuelve el problema del Deep Learning acústico con PyTorch.
2.1. ¿Cómo funciona RAVE (Realtime Audio Variational autoEncoder)?
- RAVE comprime una señal de audio compleja a un vector latente de baja dimensión (por ejemplo, 16 números continuos) y reconstruye la señal en tiempo real.
- Permite transferencia de estilo tímbrico en vivo: podés cantar frente a un micrófono y hacer que
nn~sintetice el timbre exacto de un violonchelo, un motor a reacción o un sintetizador analógico legendario, preservando la dinámica y afinación del intérprete humano.
3. Taxonomía de Representaciones de Audio para Machine Learning
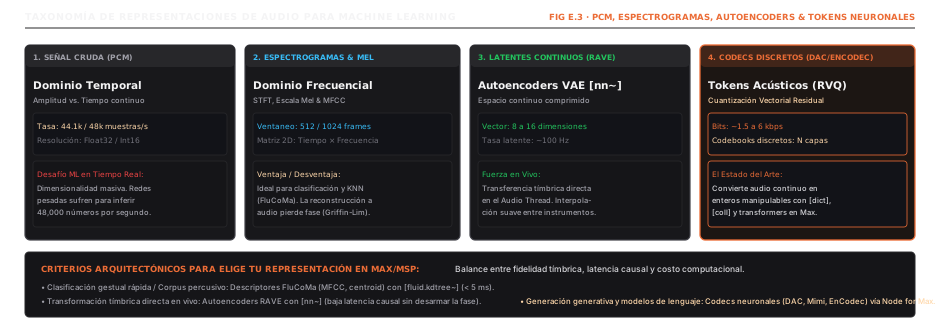
Uno de los errores conceptuales más frecuentes en el diseño de sistemas de audio con Machine Learning en Max es asumir que el sonido siempre debe entrar y salir como una forma de onda continua PCM tradicional. En la ingeniería de audio y música con IA contemporánea (2024–2026), existen cuatro capas de abstracción con compromisos matemáticos y computacionales disímiles:
-
Señal Cruda en el Dominio Temporal (PCM):
- Formato: Amplitudes escalares continuas a 44.1 kHz o 48 kHz (Float32).
- Ventaja: Cero pérdida de información de fase y retardo algorítmico nulo.
- Problema en ML: La dimensionalidad es brutal. Alimentar una red neuronal profunda con 48,000 muestras por segundo exige billones de operaciones de coma flotante por segundo (FLOPs), tornando inviable la inferencia en tiempo real en laptops estándar sin GPUs dedicadas de alta gama.
-
Representaciones Espectrales (STFT, Mel y MFCC):
- Formato: Matrices bidimensionales de tiempo frecuencia generadas por la Transformada de Fourier de Tiempo Reducido (STFT).
- Ventaja: Extraen las propiedades psicoacústicas y tímbricas que percibe el oído humano, reduciendo la dimensionalidad a unos pocos coeficientes por ventana (e.g. 13 coeficientes MFCC con
[fluid.bufmfcc~]). - Problema en ML: Pérdida irreversible de la fase de la onda. Reconstruir audio a partir de un espectrograma generado requiere algoritmos de inversión iterativa (como Griffin-Lim) o vocoders neuronales pesados que introducen latencias inaceptables para la ejecución en vivo.
-
Espacios Latentes Continuos (Autoencoders RAVE y
nn~):- Formato: Vectores continuos de dimensión reducida (típicamente 8 a 16 dimensiones) muestreados a tasas de control moderadas (~100 Hz a 200 Hz).
- Ventaja: Permite interpolación continua, morfología tímbrica en vivo y modulación con señales de control de Max (
line~,snapshot~, sliders). - Aplicación: Modificación tímbrica y síntesis neuronal directa en el hilo de audio (Audio Thread) con respuesta causal.
-
Codecs Neuronales Discretos y Tokenización Acústica (DAC, EnCodec, Mimi, SNAC):
- Formato: Secuencias de números enteros discretos (tokens acústicos) estructurados en múltiples capas de cuantización vectorial residual (Residual Vector Quantization - RVQ).
- Tasa de Compresión: Reducen audio estéreo de 44.1 kHz a tasas de apenas 50 a 100 tokens por segundo (1.5 kbps a 6 kbps) manteniendo calidad transparente de estudio.
- Integración con Max: Al transformar el audio en secuencias de enteros, el sonido puede tratarse como datos simbólicos. Se puede manipular, almacenar y secuenciar con objetos nativos de Max como
[dict],[coll],[table], o procesarlo mediante modelos autorregresivos ejecutados enNode for Max(N4M), permitiendo a Max interactuar directamente con la arquitectura de transformers contemporáneos.
4. Arquitectura Causal vs. No Causal en Vivo y Latencia Cero
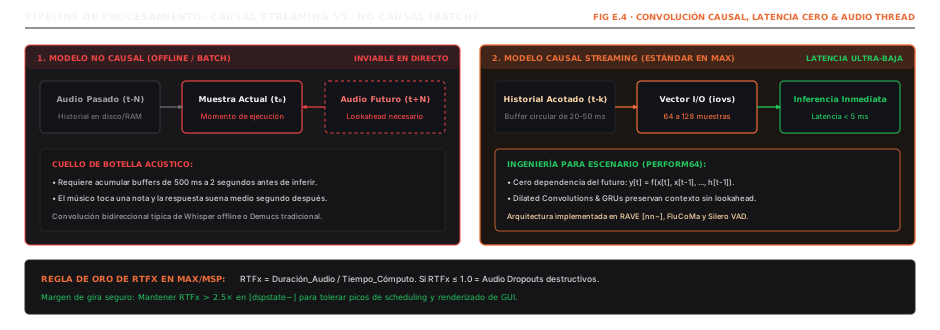
En los cursos teóricos de Deep Learning es habitual entrenar modelos en modo offline o por lotes (batch processing), donde la red tiene acceso a la totalidad del archivo de audio hacia el pasado y hacia el futuro. En un concierto en vivo con Max/MSP, el futuro no existe.
4.1. El Compromiso de la Convolución Causal
Para que un modelo de Deep Learning (nn~, redes convolucionales 1D o WaveNet) opere en tiempo real dentro del ciclo de procesamiento perform64 de Max:
- Convoluciones Estrictamente Causales: La salida en el instante debe depender única y exclusivamente de muestras en . No puede existir lookahead (anticipación temporal) mayor al tamaño del buffer vectorial I/O configurado en Max (por ejemplo, 64 o 128 muestras).
- Compromiso de Receptividad: Al suprimir el acceso al futuro, el modelo pierde contexto a largo plazo. Se compensa utilizando capas convolucionales dilatadas (dilated convolutions) o estados recurrentes ocultos (GRUs / LSTMs optimizados) con memoria circular en RAM.
4.2. Medición Cuantitativa: Factor de Tiempo Real (RTFx)
En ingeniería de sistemas de audio en tiempo real, no basta con decir que un parche “suena bien”: debemos cuantificar su Factor de Tiempo Real (Real-Time Factor - RTFx):
- Si : El sistema procesa más rápido de lo que suena. Por ejemplo, un significa que 1 segundo de audio se computa en 200 ms; el sistema tiene un 80% de margen de seguridad (headroom) para no interrumpir el audio thread.
- Si : El sistema incurre inmediatamente en Audio Dropouts (chasquidos digitales o interrupciones audibles) porque el procesador no alcanza a entregar el bloque de muestras antes de que el conversor DAC lo solicite.
En Max, monitorear el consumo del objeto [dspstate~] y calibrar el tamaño del vector de señal (sigvs) y el vector I/O (iovs) garantiza que el RTFx se mantenga holgadamente por encima de en condiciones de concierto.
5. Detección de Actividad de Voz (VAD) y Manejo de Turnos (Turn-Taking)
En instalaciones interactivas y proyectos vocales asistidos por IA, disparar inferencias de manera ininterrumpida cuando no hay nadie hablando desperdicia ciclos de procesamiento y satura los buffers. La solución de ingeniería es incorporar VAD (Voice Activity Detection):
- Detección de Energía y Cruce por Cero (ZCR):
- Implementable nativamente con objetos MSP (
[average~],[zerox~]). Provee una primera compuerta rápida para silenciar la entrada ante ruido de fondo.
- Implementable nativamente con objetos MSP (
- Clasificación Neuronal de Voz:
- Mediante modelos ultra-ligeros (como Silero VAD) ejecutados a través de
Node for Maxo mediante los clasificadores de[fluid.mlpclassifier~], Max determina con alta precisión si la señal acústica entrante corresponde a voz humana articulada o a reverberación del recinto.
- Mediante modelos ultra-ligeros (como Silero VAD) ejecutados a través de
- Máquina de Estados de Turn-Taking:
- Una máquina de estados en Max evalúa la señal de VAD junto con un retardo de silencio (silence-hangover de 200 a 400 ms). Cuando el usuario concluye una frase, el parche congela la grabación, extrae los descriptores o tokens acústicos y dispara la respuesta generativa con sincronía orgánica.
6. Mapeo Gestual Matricial y Reducción de Dimensionalidad: MnM Toolbox (IRCAM)
(Tratado fundamental de Frédéric Bevilacqua, Rémy Müller y Norbert Schnell, IRCAM Centre Pompidou).
Mucho antes de la eclosión de FluCoMa y las redes convolucionales profundas, el IRCAM formalizó las matemáticas del mapeo interactivo a través de la MnM Toolbox (creada por Norbert Schnell, autor del objeto fundamental [zl], y Frédéric Bevilacqua):
- El Problema del Mapeo Multidimensional Uno-a-Muchos: Conectar directamente 16 canales de sensores analógicos a 16 parámetros de un sintetizador mediante cables individuales produce un control caótico y poco musical.
- Análisis de Componentes Principales (PCA):
MnM introduce objetos de álgebra lineal en Max (
[mnm.pca],[mnm.biplot]) que computan en tiempo real la matriz de covarianza de las señales gestuales y proyectan los datos sobre sus autovectores dominantes. Esto reduce un flujo de 10 acelerómetros ruidosos a solo 2 o 3 coordenadas ortogonales continuas que capturan el 95% de la intención expresiva del intérprete humano. - Modelos Ocultos de Markov (HMM) para Reconocimiento Gestual:
A través de
[mnm.ring]y matrices de transición de estados continuos, MnM permite entrenar al parche para que reconozca trayectorias espaciales dinámicas (como el ataque de una batuta o el frotado de un arco) y dispare respuestas generativas sincrónicas en Max.
7. Laboratorio Práctico: Mapeo Gestual Neuronal (MLP Regressor)
En el parche lab_apendice_e_machine_learning.maxpat:
- Simulamos un regresor de red neuronal que aprende a interpolar 4 parámetros de un sintetizador FM complejo a partir de una posición bidimensional en un pad táctil.
- Se ilustra el ciclo canónico: Grabación de Ejemplos de Entrenamiento Ajuste de Pesos (Train) Inferencia en Tiempo Real.
- Se evalúa la latencia de inferencia y la estabilidad del cómputo con señales continuas para garantizar que el RTFx se mantenga óptimo.